より良いプログラミングライフを送るために知っておくべきこと
8月12日に、新しく監訳した本が出ます。

アート・オブ・クリーンコード: 複雑さを避けてシンプルに生きるためのベストプラクティス
この本、タイトルだけ見ても内容が想像しにくいと思います。
そこで、出版社の許可を得て、以下に監訳者まえがきを全文公開します。
監訳者まえがき
プログラミングの世界は、その誕生以来、絶えず進化と複雑化を続けてきました。新しい言語、フレームワーク、ツールが次々と登場し、私たちは日々、膨大な情報の波にさらされています。技術を習得し、コードを書き、プロダクトを開発する中で、「もっと効率的にできないか」「もっと本質的なことに集中したい」と感じることは、プログラマであれば誰しもが経験することではないでしょうか。
株式会社ホクソエムのメンバーも長年ソフトウェア開発に携わる中で、プロジェクトの遅延、増え続ける技術的負債、コミュニケーションの齟齬、そして何よりも、本来集中すべき価値創造から遠ざかってしまう状況に、何度も直面してきました。多くの書籍が特定の技術や手法について深く掘り下げていますが、より根本的な「プログラマとしてのあり方」や「生産性の本質」に光を当てるものは、そう多くはありません。
そのような中、本書に出会って我々は強い共感を覚えました。著者のクリスチャン・メイヤー氏は、プログラミングにおける普遍的な課題である「複雑さ」に正面から向き合い、それを乗り越えるための9つの力強い原則を提示しています。それは、単なる小手先のテクニックではなく、プログラマがより少ない労力でより多くの価値を生み出すための、時代を超えた知恵ともいえるでしょう。
本書で紹介される「80/20の法則」「実用最小限の製品(MVP)」「クリーンコード」「フロー」「Unix哲学」「レス・イズ・モア」といったルールは、個別に耳にしたことがある方も多いでしょう。本書はそれらを「フォーカス」という一つのキーワードでつなぎ合わせ、一貫した哲学として提示しています。情報過多で変化の激しい現代において、「何をやらないか」を決め、「最も重要なこと」に集中する能力は、プログラマにとってますます重要なスキルとなっています。
日本では特に過剰品質や完璧主義が、プロジェクトの進行を妨げたり、開発者を疲弊させたりするといわれています。本書で提唱される「早期にプロトタイプを構築する(第3章)」「早すぎる最適化は諸悪の根源である(第5章)」「悪いほうが良い(第7章)」といった考え方は、よりリーンでアジャイルな開発文化を目指す上で、示唆に富むものとなるでしょう。また、「フロー(第6章)」や「フォーカス(第9章)」に関する章は、日々の業務に追われがちな私たちが、集中力を高め、より創造的で充実した仕事をするためのヒントを与えてくれます。
本書は、特定のプログラミング言語に依存するものではありません。その根底にある原則は、あらゆる言語、そしてあらゆる経験レベルのプログラマにとって有益です。特に、初心者の方にとっては、複雑さの罠にはまる前に、健全な開発習慣を身につけるための指針となるでしょう。経験豊富な方にとっては、自身の経験を振り返り、より高いレベルの生産性と影響力を目指すための新たな視点を与えてくれるはずです。
本書が、読者の皆様のプログラミングライフをより豊かに、そして生産的にするための一助となれば、監訳者としてこれに勝る喜びはありません。最後に、本書の翻訳にご尽力いただいた仲村智氏、吉永尊洸氏、ならびに出版にあたり多大なるご支援をいただいた共立出版の河原優美氏,菅沼正裕氏および関係各位に、心より感謝申し上げます。
2025年7月
株式会社ホクソエム
ぜひ購入をご検討ください!
書籍「評価指標入門」の出版に寄せて 〜監修の想い(O・MO・I)
監修させていただいている評価指標入門なんですが、株式会社ホクソエムの代表取締役CEOである私、牧山幸史(以下、コージー牧山)、はじめてこの企画を聞いた時は「その特徴は単に評価指標をまとめた辞書やないかい!そういう”売れそうだから書く”みたいな商業的なマインドが学術界の価値を貶め云々」と思ったのですが、上梓された高柳さん(タカヤナギ=サン)の壮大なるお話を聞いているうちに「これはひょっとして数理モデリングとしても奥深い世界が広がっているの?面白いかも!」と思い監修社として名乗りを上げた次第です。
一方、本書の内容と皆様の期待値がややズレているのではないか?と不安には思っておりまして、これは監修社として一肌脱いでおかなければいかんなと、自然界に存在する第5の力「期待値調整力」を見せなければならないなと思い筆を取った次第です。
以下、私、コージー牧山の視点で「書いてあること・書いてないこと・書きそびれた」ことをここに記すことにより潜在、あるいはすでに予約されてしまった方々への期待値調整とさせていただきます。
書いていること
まずMAEやRMSE、またAUCやF値などベタベタな評価指標については網羅的ではないですが説明しています。また「結局、方針としてどういう評価指標を選んだらいいんだ?」という問いに対する答えも用意しており、その”答え”を御社のビジネスに適用するための考え方、及びその考え方に則ったいくつかの例を示しています。コージー牧山的には評価指標自体よりも、”考え方”の方が重要だと考えており、そちらの点を厚めにやって欲しいなと執筆陣にお願いしこのような形となりました。こう考える詳しい理由は次の”書いていないこと”を参照ください。
書いていないこと
逆に書いていないことでいうと「学術書・論文から評価指標を徹底的に調べ上げ全列挙」はしていません。これは本質的に無意味です。なぜなら、仮に全列挙していたとして、読者が「どこかに私の問題を解くための答えがあるんじゃないか?」と期待し辞書を”A”から”Z”まで全てBrute Forceに探索するようなものだからです。しかし、そもそもそこに答えはないと。結局のところ、”私の問題”が固有すぎてヘルスチェックの意味で教科書的な評価指標を使えはせよ、都度都度自分たちのやっていることに対して合わせて妥当な結論を出すべきであるとコージー牧山は考えます。私以外私じゃないんです、当たり前だけどね。
書きそびれたこと
相当な言い訳ですが、今回はスケジュールやコージー牧山・執筆陣・編集含めた制作部隊の楽屋/舞台裏がかなりグチャグチャしてしまったため、書き損ねている話が結構出てしまいました。例えば
- カリブレーションとは何か?どういう場面で重要になるのか?評価指標とどう関連するのか?
- 推薦/ランキングでの評価指標
- LTVなど評価指標を用いて陽に書き下すことが難しい問題への処方箋
- データサイエンティストなら誰もが持っていた第六感
- AIの心を壊すとある星の光
- PoC死の他にあった4つの結末
などがあります。少なくとも1つ目については追々、本BLOGか技術評論社さんのサイト上で記事として公開したいと思います。
以上、ご購入検討の際に本文章がお役に立つと幸いです。
※この文章は株式会社ホクソエム開発”HoxoGPT”のサポートを受け執筆されました

RでCQT(Constant-Q変換)をやってみる
ホクソエムサポーターの松本です。音楽を作ったり聴いたりするのが趣味なので、音楽分析に興味があります。音データの分析にはPythonだとlibrosaというとても便利なパッケージがあるのですが、Rにはそういった汎用的なパッケージがなくてちょっと不便です。 最近ふとRでCQT(Constant-Q変換)をしてみたいと思い、既存のパッケージを使ってできないか探してみたところ特に見つからなかったので、どのように実装すればいいのか調べてみました。
スペクトログラムについて
音声や音楽データの分析を行う際には生の波形をそのまま扱うのではなく、スペクトログラム(時間周波数表現)に変換したものを特徴量として利用することがあります。下の画像は「あいうえお」という音声を録音したデータを表したものです。


左図の波形データは横軸は時間、縦軸は振幅を表します。右図のスペクトログラムは横軸は時間、縦軸は周波数、色はその時間・周波数の成分の強度を表します。
このように視覚化した際、波形データは音の大きさの変化くらいしか分かりませんが、スペクトログラムは周波数ごとにどのように時間変化していくか等が分かります。視覚的に特徴を捉えやすく、画像のようにも扱うことができるので画像処理の手法を応用した分析や変換にも利用しやすいといった利点があります。
スペクトログラムはSTFT(短時間フーリエ変換)によって算出するのが一般的ですが、この方法の問題点として、音高の観点からすると、低域で周波数分解能が低くなるという点があります。人間の聴覚特性として低域では周波数の違いに敏感である(周波数分解能が高い)が、高域になるにつれて鈍感になる(周波数分解能が低くなっていく)という特性があります。音高の国際的な基準はラ(A)=440Hzとなっていますが、1オクターブ上のラは880Hzでちょうど二倍の周波数になります。1オクターブの間には12個の音階があり、これらは公比 $\sqrt[12]{2}$ の等比数列となっています。
STFTでは切り取った信号に対して全ての周波数で同じ窓幅でフーリエ変換を行いますが、CQTではこうした特性を考慮して対数周波数を利用し、かつ周波数ごとに窓幅を変化させて変換することで、音高に対応して周波数分解能を変化させています。
実装
以下ではピアノ演奏を録音した音源を使って、各種プロットを行う例を示します。
音源の読み込みには tuneR パッケージ、スペクトログラムのプロットには seewave パッケージを利用しています。
library(tuneR)
library(seewave)

# wavファイルの読み込み
wav <- readWave("pf.wav")

# 波形のプロット
plot((seq(wav@left) - 1) * 1 / wav@samp.rate, wav@left, type="l", xlab="time", ylab="amplitude")

# STFTによるスペクトログラムのプロット
ggspectro(wav, ovlp=50) +
  scale_y_continuous() +
  geom_tile(aes(fill=amplitude))


次にCQTを算出してみます。実装はこちらの記事を参考にさせて頂きました。 音楽プログラミングの超入門(仮): 【Python】 Constant-Q 変換 (対数周波数スペクトログラム)
library(signal) # ハミング窓を使うためにsignalパッケージを利用

# パラメータの設定
qrate <- 1
fmin <- 60
fmax <- 6000
bins_per_octave <- 12
hop_length <- 512
two_pi_j <- 2 * pi * 1i

# 対数周波数ビンの数とそれらに対応する周波数を算出
nfreq <- round(log2(fmax / fmin) / (1 / bins_per_octave)) + 1
freqs <- fmin * (2 ** ((seq(nfreq) - 1) * (1 / bins_per_octave)))

# CQTを行うフレーム数とそれらに対応する時間を算出
nframe <- ceiling(length(wav@left) / hop_length) + 1
times <- seq(nframe) * hop_length * (1 / wav@samp.rate)

# 窓幅を設定するためのパラメータ
Q <- (1 / ((2 ** (1 / bins_per_octave)) - 1)) * qrate

# CQTスペクトログラムのための行列を初期化
ret <- matrix(0, nframe, nfreq)

# 周波数ごとに窓幅を変えてCQT
for (k in seq(nfreq)) {
  nsample <- round(wav@samp.rate * Q / freqs[k])
  hsample <- round(nsample / 2)

  phase <- exp(-two_pi_j * Q * seq(nsample) / nsample)
  weight <- phase * hamming(nsample)

  # 各フレームごとに信号を切り取る→重みを掛けてretに代入
  for (iiter in seq(nframe)){
    iframe <- iiter
    t <- (iframe - 1) * hop_length * (1 / wav@samp.rate)
    istart <- (iframe - 1) * hop_length - hsample
    iend <- istart + nsample
    sig_start <- min(max(1, istart + 1), length(wav@left))
    sig_end <- min(max(0, iend), length(wav@left))
    win_start <- min(max(1, sig_start - istart), nsample)
    win_end <- min(max(0, length(wav@left) - istart), nsample)
    win_slice <- weight[win_start : win_end]
    y <- wav@left[sig_start : sig_end]
    ret[iiter, k] <- sum(y * win_slice) / nsample
  }
}
次に算出したCQTスペクトログラムをggplotを使ってプロットしてみます。実装はseewaveパッケージのggspectroを参考にさせて頂きました。https://github.com/cran/seewave
library(ggplot2)

P <- abs(t(ret)) # 絶対値に変換し、振幅を取り出す
P <- P/max(P) # ノーマライズ
P[P == 0] <- .Machine$double.eps # log10(0)で-Infにならないようにする
P <- 20*log10(P) # dBスケールに変換

# 外れ値で表示が変にならないように範囲を設定
limit_upper <- 0
limit_lower <- -50

# ggplotで表示するためのデータフレームを作成
frequency <- rep(freqs, times=ncol(P))
time <- rep(times, each=nrow(P))
amplitude <- as.vector(P)
amplitude[amplitude < limit_lower] <- limit_lower
df <- data.frame(time, frequency, amplitude)

tlab <- "Time (s)"
flab <- "Frequency (kHz)"

# CQTスペクトログラムのプロット
ggplot(df, aes_string(x="time", y="frequency", z = "amplitude")) +
  xlab(tlab) +
  ylab(flab) +
  scale_y_log10(breaks=freqs[seq(1, length(freqs), 12)]) +
  geom_tile(aes(fill=amplitude))

CQTのスペクトログラムの算出とプロットを行うことができました。
プロットを見ると比較的はっきりとピアノで演奏された音が浮き上がっていることが分かります。CQTはメロディーや和音など音楽的な要素の分析によく使われる特徴量で、音楽分析においてはSTFTを使うよりも有用な場合が多いと思います。
参考文献
- 高校数学の美しい物語 - 音階と数学 https://manabitimes.jp/math/1353
- 音楽プログラミングの超入門(仮) - 【Python】 Constant-Q 変換 (対数周波数スペクトログラム) https://yukara-13.hatenablog.com/entry/2013/12/01/222742
- Wizard Notes - 定Q変換 (CQT: Constant-Q Transform) の 解説(音高・コード・メロディの分析向け) https://www.wizard-notes.com/entry/music-analysis/constant-q-transform
- seewave ~ an R package dedicated to sound analysis and synthesis ~ https://rug.mnhn.fr/seewave/
機械学習とビジネスを橋渡しするものこそ評価指標であり, ”全てのビジネスは条件付期待値の最大化問題として書ける”仮説についての一考察
はじめに
株式会社ホクソエム常務取締役のタカヤナギ=サンです、データサイエンスや意思決定のプロ・経営をしています。
掲題の件、現在、某社さんと”機械学習における評価指標とビジネスの関係、および宇宙の全て”というタイトルの書籍を書いているのですが、 本記事のタイトルにあるような考え方については、論文・書籍などを数多く調査しても未だお目にかかることができず、これをいきなり書籍にしてAmazonレビューなどでフルボッコに叩かれて炎上して枕を涙で濡らすよりも、ある程度小出しにして様々な人々の意見を聞いた方が良いのではないかと思い独断で筆を取った次第です。
筋が良さそうなら論文にするのも良いと思っている。
「いや、そんなもん会社のBLOGに書くんじゃねーよ💢」という話があるかもしれないですが、ここは私の保有する会社なので何の問題もない、don't you?
こういうビジネスを考えてみよう
「この人、家賃を滞納しそう?」AIが予測 入居審査を45分→16分に - ITmedia NEWS
という話を見かけたので、これに似た題材にしてみようと思う。
問題を簡単にするため、
- 貴方は家賃保証会社の経営者としてN人の入居希望者に対し、家賃保証審査を行う
- 貴方にできることは各入居希望者と家賃保証契約を「する・しない(結ぶ・結ばない)」を選ぶことだけ
- 家賃保証契約をする場合(入居希望者に実際に入居して貰う場合)
- ある期間(1年とか3年とか)において一度も滞納することなく家賃を払い続けてくれたら、入居者からS 円/人の保証料を手に入れる(これが売上)
- ある人が1回でも家賃を滞納したら、その人からもらったS円の保証料全額と保証会社としてD円の金額を上乗せして家のオーナーにお渡しする(これが家賃保証会社として見たときの損失)
- 家賃保証契約をしない場合
- その入居希望者からは何のお金ももらえない(家賃保証契約してないので当たり前)
という設定で考えてみよう。
人件費や家賃などなどのコストは一切考えないことにし、この「家賃保証料 - 滞納への保証金」がこの家賃保証会社の利益です。
そのビジネス、こういう条件付期待値でかけまっせ
このビジネスの利益(ビジネス施策によって条件つけられた条件付き期待利益)をと書くと、これは以下のように書ける。
ここは所謂「ビジネスの数理モデリング」で、各社・ビジネスによって異なる部分です。
最近はここをどれだけうまく書き下せるかが焦点だと考えています。
S、Dは先程説明したとおりの保証料としての儲けとうっかり滞納された場合の損失で 、
は {} の中がTRUEなら1, そうでなければ0になるような指示関数であり、
は「ユーザ i が家賃を滞納しない優良な入居者ならTRUE、そうじゃない(家賃を滞納すれば!)ならFALSE」となるような論理変数です。
同様に
は「ビジネス施策として家賃保証する(Guarantee)場合にはTRUEで、そうでなければFALSE」となるような論理変数です。
ようするにユーザiに対するビジネス施策(ここでは家賃保証契約をするかしないかということ)のこと。
重要なポイントは
- 機械学習によるビジネス成果(ここでは利益向上)は、この
を通じてしか影響しえない
という点です。 「機械学習は所詮ビジネスにとってのおまけ、あってもなくても良い」としばしば言われる所以はここにあるのです。
しかし、Nがとても大きい場合には、各々の入居希望者iに対して適切なビジネス施策(ここでは家賃保証契約をするかしないか)を提供することは、 人間がやるには大変な手間とコストがかかるため敬遠される作業であり、機械学習やデータサイエンスを極めている我々の出番になるわけです。
家賃を保証するかしないか、まさに2値クラス分類であり、プロのデータサイエンティストには朝飯前。
サクッとやろうぜ、と。
従って、以下の議論では は何らかの2値クラス分類モデルで決定するとします。
ここでは"家賃を滞納しない入居者”をPositiveなケースとします。
従って、"家賃を滞納してしまう入居者"のケースがNegativeなケースです。
評価指標 〜機械学習とビジネスを橋渡しするもの〜
ここまでの話と機械学習や評価指標がどうつながっているのか、まだ皆さんその気配を感じれてないと思います。 ですので、ここで、少し先ほどの数式を変形してみましょう。
この第一項目の期待値の中身の部分をグッと睨んで見て欲しい。 この期待値の中身が1となるのは「実際に入居者が家賃を滞納しなかった、かつ、機械学習モデルの予測結果として"家賃保証契約をする"となっているケース」であり、これは機械学習の評価指標の文脈で言う True Positive (TP) の場合と近そうじゃないか?
また同様に第二項目の中身の部分をグッと睨んで欲しい。 こっちは「機械学習モデルにおいて「家賃保証契約締結するぞ!」と予測した場合 1 」になるものであり、 これは(True Positive + False Positive)の個数になりそうではなかろうか?
実際、この期待値計算をサンプルサイズ1(つまり、1個人から1データをもらう)としてみたものこそが、我々の手元にあるデータなのであり、我々が唯一手元でいじくり回して機械を学習させるために使えるデータなのである。
実際に計算してみると以下のようになる。
さらに、もう少し評価指標を全面に押し出した形式で書くと、
となる。できた!!!
この数式は美しい形式になっており「家賃保証契約をすると機械学習モデルで決定した人数(TP + FP)に、機械学習モデルの評価指標であるPrecisionを適当な重みをかけて、計算したもの」という形式になっている。
しばしば私が受ける質問として「2値クラス分類の予測確率のしきい値をどのように決めたら良いでしょうか?」というものがあるが、ここで紹介している問題については今それを答えることができます。 実際に皆さんが機械学習を活用して、このビジネスモデル(利益形式)の商売をしている場合、 家賃保証をする・しない2値分類問題の予測確率のしきい値は、この利益が最大になるようなしきい値を使ってやればよいということになる。 すなわち、ここではPrecision(とTP+FP)という評価指標が機械学習とビジネスを橋渡ししており、家賃保証する・しないを決める予測確率の閾値を制御することで条件付期待値の最大化問題を解き、利益を最大化することができるのだ!やった!
ポイントとしては、 ビジネスモデル(利益計算)がデータサイエンスの教科書どおりのAUCやF値、PrecisionやRecallとはちょっとずれてくる点です。 ここが非常に重要で、この”ズレ”こそが機械学習をビジネスに適用した際に「あ、あれ?なんかうまく儲かってなくね?」となる一要因だとタカヤナギ=サンは考えています。 そして、厄介なことに「この利益計算こそがビジネスの根幹であり、ある程度の分類はできるだろうが、それは会社ごとに異なるので一般論を打ち立て得ない」という点です。 少なくともビジネスモデル(SaaSモデルなのか売り切りモデルなのかなどなど)ごとには考える必要があるのです。
「君が機械学習において何を大事にしたいか?それは各社の皆さんのビジネスモデル次第、や!頑張って考えようぜ!」ということなのです。
まとめ
ここでは家賃保証会社のビジネスを通じて、そのビジネスの利益を条件付期待値として書き下し、それを最大化するための方法が実は機械学習の評価指標と密接にリンクしていることを紹介した。
最近考えていることとして、この考え方はビジネス全般において普遍的に成り立つものであり、全てのビジネス(売上、利益などのKPI計算)はこの形式出かけるだろうという仮説を個人的に持っている。
この考え方に明らかなミスや間違いを見つけた方は是非 Shinichi Takayanagi (@_stakaya) | Twitter まで連絡してほしい(そして一緒に本を書いて欲しい)。
今回はPrecisionだけが顔を出してRecallが一切顔を出してこなかった点にも注目して欲しい。 これは「家賃保証契約をしない」場合において、一切の損失が発生しないと見做しているからであり、そこを何がしかの形で取り込むと彼(Recall)も顔を出してくることになる。 この辺はちゃんと書籍にまとめようと思うので期待して欲しい(私が書くとは言ってない&共著者に書かせる!)
pytest fixtureの地味だけど重要な部分について
こんにちは。ホクソエム支援部サポーターのPython担当、藤岡です。 最近はデータエンジニア見習いとしてBI周りを触っています。
今回はpytestのfixtureについての記事です。
pytest自体が有名で記事もたくさんあるので、今回は地味だけど重要だと個人的に思っている
usefixturesとスコープについて取り上げます。
地味とはいえ、pytestの初心者がfixtureを使いこなすためのステップアップに必要な内容だと思います。 ぜひマスターしていただければ幸いです。
1. 前書き
- 基礎的なことに関してはこの記事にとても簡潔にまとまっているので、こちらをまず読むのがオススメです。とても良い記事です。
- pytestは独自の書き方を持ち込んでいるライブラリです。その機能を使いこなすと「綺麗」なコードにはなりますが、反面それは使われている機能を知らない人にとってはこの上なく読みにくいものです。やりすぎて可読性が下がらないよう、用法用量を守りましょう。
- 本稿の環境はこちらのリポジトリからcloneできますので、試しながら読んでみてください。
2. fixtureとusefixtures
pytestのfixtureの機能としてもっとも基本的なものがオブジェクトの生成です。 例えば、
@fixture
def values():
    return [2, 1, 3]

@fixture
def sorted_values():
    return [1, 2, 3]

def test_sorted(values, sorted_values):
    assert sorted(values) == sorted_values
といったようなものです。 おそらく、fixtureのイメージとして一番強いのがこの使い方ではないでしょうか。
しかし、実際はそれだけに止まりません。
例えば、機械学習のコードなどでは乱数が使用されているため、結果を固定するには乱数シードの固定が必要です。 こうした処理をfixtureとして用意するとこのようになります。
import random

@fixture
def set_seed():
    random.seed(0)
このように、何も返さず、テストにただ前処理を施すのもfixtureの機能なのです。
さて、少し定義の話をします。 "test fixture"を辞書で引くと「試験装置」と出てきます。 Wikipediaの言葉を借りればtest "environment"、つまり環境です。
なので、入出力のオブジェクトはもちろんのこと、乱数シードの固定、データベースやサーバへのコネクション(のスタブ)の確立、さらにファイルやフォルダの生成/削除などもfixtureであり、基本的にはfixtureデコレータを使って実装するべきものです。
話を戻しますが、何かしらの処理だけをして値を返さないfixtureはテストケースの引数として渡すのは不適切です。
こういった場面では、usefixturesデコレータを使うことでテスト前にfixtureの処理を実行することができます。
@pytest.mark.usefixtures('set_seed')
def test_fix_seed():
    rand1 = random.random()
    ramdom.set_seed(0)
    rand2 = random.random()
    assert rand1 == rand2
しかし、この例ではシードの固定を内部でも一回やっていてイマイチです。
というわけで、今度はシードの初期化をさせるのではなく、その処理をするコールバックを返すことで解決します。
import random

@fixture
def seed_setter():
    return lambda: random.seed(0)

def test_fix_seed_2(seed_setter):
    seed_setter()
    rand1 = random.random()
    seed_setter()
    rand2 = random.random()
    assert rand1 == rand2
関数を返すのは公式でも使用されているテクニックです。
例えば、predefinedなfixtureには一時ディレクトリのパスを返すtmpdirがあるのですが、
一時ディレクトリを生成するためのコールバックtmpdir_factoryもあります。
もちろん、fixtureではなくヘルパ関数としてseed_setterを定義して呼び出すという選択肢もあるので、ケースバイケースで選択しましょう。
上記の例ではヘルパ関数の方がいいと思いますが、乱数シードの固定が至る所で使われるならばfixtureの方がいいです。
他にusefixturesを使う例として、unittestのpatchがあります。
下のサンプルコードでは、mymodule.ObjectWithDBのconnectメソッドをMagicMockに置き換えています。
これをusefixturesで宣言すれば、データベースコネクションをスキップしてObjectWithDBを使えます。
from unittest.mock import patch
from mymodule import ObjectWithDB

@fixture
def ignore_db_connection():
    with patch("mymodule.ObjectWithDB.connect"):
        yield
usefixtureはとても便利ですが、テストケース以外では使えないという点に注意してください。
例えば、以下のようなことはできません (エラーは吐きませんが、無視されます)。
@fixture
@pytest.mark.usefixtures('set_seed')
def random_value():
    return random.random()
代わりにこうしておけばOKです。
@fixture
def random_value_factory(seed_setter):
    seed_setter()
    return random.random()
3. fixtureスコープと変数スコープ
fixtureは基本的にはテストケースごとに実行されます。
以下のサンプルコードで確かめてみましょう(pytest コマンドに-s オプションを付けるとprint出力が見られます)。
@fixture
def foo():
    print("start")
    yield
    print("end")

def test_1(foo):
    print("test1")

def test_2(foo):
    print("test2")
start -> test1 -> end -> start -> test2 > end の順番でプリントされ、テストごとにfixtureの処理が実行されています。
これは再現性の観点からは良いのですが、その反面オーバーヘッドが発生します。
例えば、テスト用のデータセットにアクセスするfixtureがあったとします。 一回に3秒の初期化がかかったとして、1,000のテストケースで使用されるとしたら、それだけで50分かかります。
そこで、試しにテスト実行順をstart -> test1 -> test2 > endというように変更してみます。
そのためには、pytest.fixtureの引数にscope="session"を加えます。
@fixture(scope="session")
def foo_session():
    print("start")
    yield
    print("end")
実行してみると、意図した通りの挙動になっていることが分かります。
このように、fixtureにおける実行タイミング、つまりいつyield(return)に入って、いつyieldに戻る(returnの場合は特になし)のかを決定するためには、
scopeというパラメータを設定します。
変数のスコープと混同するので、本稿ではそれぞれ変数スコープ、fixtureスコープと呼ぶことにします。
fixtureスコープは以下の4種類があり、それぞれ変数スコープとよく似た入れ子状のブロックとしてのまとまりを持ちます。
- そのテストケース自身のみ*1を含む最小単位であるfuntionスコープ (デフォルト)。
- クラスの内部の変数スコープと対応する、classスコープ。
- 一つのモジュールの変数スコープと対応するmoduleスコープ。
- 全てのテストケース/fixtureを含むsession(package)スコープ。
functionスコープ以外では、最初にyieldした(returnした)結果をキャッシュして同じスコープのテストに渡して、そのスコープの終端でyield後の処理を実施しています。
これは、test_1とtest_2のそれぞれについて、同じオブジェクトIDのオブジェクトが渡されていることからも確かめられます。
fixtureスコープは基本的には狭いものを使用しましょう。つまり、デフォルトから変更しないのがベストです。 多少の時間的なオーバーヘッドがある場合でも、問題にならないうちは広げるべきではないでしょう。 というのも、キャッシュするという性質上、広いスコープのfixtureを使い回すとそのテスト間に 予期しない依存関係が生じてしまう恐れがあるためです。 次節以降で詳しく解説していきます。
4. fixtureスコープの落とし穴
さて、以下のテストには問題があります。どこか分かりますか?
@fixture(scope="session")
def ids():
    return [3, 1, 4]

def test_ids_sort(ids):
    ids.sort()
    assert ids == [1, 3, 4]

def test_ids_pop(ids):
    ids.pop()
    assert ids == [3, 1]  # fail here
わからない場合は実行してみましょう。すると、以下の行を含むログが表示されます。
E       assert [1, 3] == [3, 1]
E         At index 0 diff: 1 != 3
どうやら、idsがtest_ids_sortの中でソートされた後にそのままtest_ids_popに渡されてしまっているようです。
キャッシュした値がうっかり破壊的処理によって書き変わってしまう、典型的なバグです。
今回の場合は簡単に分かる話ですが、実際にこのバグに遭遇する場合はたいていもっと厄介です。
現実には、同じfixtureを使うテストが別々のスクリプトに点在している場合もあります。
加えて、テストがバグっている場合、元のソースがバグっている場合の間で区別がしづらいのも問題です。
さらに、今回のケースだとtest_ids_popだけをテストしてやると通ってしまいます(PyCharmであれば簡単にできます)。
こんな事例を想像してみてください。
あなたは新しくテストをいくつか追加しました。それらが通ることは確認済みです。しかしpushして「さあ帰るぞ」と支度をしていたら、CIからエラーが返ってきてしまいました。
どうやら、まったく弄っていない別のテストがエラーを吐いているようです。でも、そのテストだけを走らせてみるとエラーが再現できません……。
残業中なら、xfailを付けて逃げたくなるような話です。
言うまでもないですが、この依存関係を利用するなんてことは論外です。
他にも、広いfixtureスコープのfixtureから狭いfixtureスコープのfixtureは呼び出せないという制限があるので、 無闇に広げるとこの制限に引っかかります。 例えば、以下のfixtureを呼び出すとエラーを吐きます。
@fixture
def foo():

@fixture(scope="session")
def foo_session(foo):
    ...
ただ、どうしてもfixtureスコープを広げたい場合もありますので、 その場合には以下の事項に気をつけましょう。
- 渡すオブジェクトがimmutableかどうか。
- 極力immutableなオブジェクトを渡す。
- mutableオブジェクトならば、テストやテストされる関数等で破壊的なメソッドを呼ばないように細心の注意を払う。
- immutableオブジェクトでも、DBコネクション等の外部参照をするfixtureを渡す場合には、それがテストごとにリセットされるかどうか(リセット用fixtureを作って常に使うようにするのも手です。)。
5. fixtureの可用範囲
これまでの例ではコードスニペットだけを扱ってきましたが、実際のテストスクリプトは複数のテストケース、それらをもつクラス、果ては複数のスクリプトにまたがります。 fixtureのスコープだけでなく、fixtureの可用範囲、変数でいうところの変数スコープを理解する必要が出てきます。
本節ではその内容について解説します。
まず、基本的には「テストケースが定義された場所」を基準に考えればOKです。
例えば、以下の例ではtest_fooとtest_foo_2は同じような挙動をします。
@fixture
def foo_fixt():
    return "foo"

def test_foo(foo_fixt):
    assert foo_fixt == "foo"

foo_var = "foo"

def test_foo_2():
    assert foo_var == "foo"
テストケースはこのモジュールのグローバル領域に定義されているので、 同じ領域に定義された変数と同様に参照できます。 ここで注意してほしいのが、あくまでグローバル領域であり、これはテストケースの関数ブロックの外側の話です。
クラスが絡むと、この差がもう少しはっきり出てきます。
class TestBar():
    @fixture
    def bar_fixt(self):
        return "bar"

    def test_bar(self, bar_fixt):
        assert bar_fixt == "bar"

    bar_var = "bar"
    ref_bar_var = bar_var

    def test_bar_2(self):
        assert type(self).bar_var == "bar"

    @fixture
    def bar_fixt_2(self):
        return type(self).bar_var

    def test_bar_3(self, bar_fixt_2):
        assert bar_fixt_2 == "bar"
クラスブロックでは特殊な名前解決が行われるので、例えばbar_fixt_2からクラス変数bar_varは参照できません。
上の例ではtype(self)を通じてアクセスしています。
一方、クラスブロック内では(当たり前ですが)参照可能なので、クラス変数ref_bar_varの定義時にbar_varを参照できます。
fixtureについても、bar_var同様に直接参照可能です。
テストケースの定義されたブロックで名前解決をしていることが、先ほどの例よりもはっきりと分かります。
さて、さらにテストが大きくなってきた場合を考えてみましょう。 多くのテストケースが作成され、似たようなfixtureが複数のスクリプトに定義されるようになってしまいます。 当然、fixtureを使い回したいという欲求が出てきます(よね?)。
pytestでは、スクリプト間でfixtureを使い回すための仕組みが提供されています。 試しに、conftest.pyという名前のファイルをテストフォルダ直下に作成し、 その中にfixtureを入れてみてください(もちろん、サンプルリポジトリにも用意されています)。 すると、そのfixtureを全てのテストで使うことができます。
このようにconftest.pyは便利なのですが、fixtureをどんどん作成していると次第に汚くなってきます*2。
なので、conftest.pyをある程度分割することをオススメします。 conftest.py内で定義されたfixtureの使用可能な範囲は、正確には「conftest.pyの定義されたフォルダとそのサブディレクトリのテスト」です。 なので、テストをサブディレクトリに分割してその中にconftest.pyを作成すれば分割できます。 また、conftest.pyはいわゆるグローバルなオブジェクトが作られてしまうので、 ある程度狭い範囲で利用可能になるように(とはいえconftest.pyが増えすぎないように) するのがベストかなと思います。
余談ですが、筆者は他のファイルで定義したfixtureをconftest.pyでimportすることでconftest.pyを綺麗に保っていたことがあります。 しかし、fixtureのimportは非推奨であり今後のバージョンでの動作は保証されないのでimportはしないようにしましょう *3。
6. fixtureの連鎖と階層構造
pytestでは、fixtureを定義する際に別のfixtureを入力として受け取ることが可能です。 知っている方も多いと思うので、ここまでの例でもいくつかの例でこの機能を利用していました。 本節ではさらにその細かい部分に突っ込んでいきます。
6.1 fixtureの循環/再帰エラー
fixtureからfixtureを呼び出すことで、fixtureどうしに有向の依存関係が発生します。 そして、この依存関係を解決する必要があるので、循環や再帰があってはいけません。
# 循環の例
@fixture
def cycle_1(cycle_3):
    return cycle_3

@fixture
def cycle_2(cycle_1):
    return cycle_1

@fixture
def cycle_3(cycle_2):
    return cycle_2

def test_cycle_fixt(cycle_3):
    ...

# 再帰の例
@pytest.fixture
def recursive_fixture(recursive_fixture):
    ...

def test_recursive_fixture(cycle_3):
    ...
上記の例を実行すると、
recursive dependency involving fixture '***' detected
といったようなエラーが発生します。
testからfixtureを呼び出す場合と同様に、fixtureからfixtureを呼び出す場合でも 変数スコープやconftest.pyの階層関係が成立します。 なお、最上位にあたるfixtureはルートディレクトリのconftest内のfixtureかと思いきや、 実はpredefinedなfixtureです*4。
6.2 同名fixtureの連鎖
次に、下の例のように同じ名前のfixtureを複数作って、一つ目で二つ目を上書きするような例を考えてみます。
@fixture
def foo_fixture():
    return [1, 2, 3]

@fixture
def foo_fixture(foo_fixture):
    return foo_fixture + [4, 5]
残念ながら、上の例はエラーとなってしまいます。
同一のfixtureを定義した場合、この部分が含まれたモジュールがimportされた場合と同様に、後に定義された方が前に定義された方を上書きしてしまいます。
つまり、一つ目のfoo_fixtureが無視されて二つ目のfoo_fixtureが自身を再帰的に入力としていることになり、上記のエラーが出てしまいます。
しかし、下のように変数スコープを変えることで同じ名前のfixtureを入力とすることが可能です。
@fixture
def foo_fixture():
    return [1, 2, 3]

def test_foo(foo_fixture):
    assert foo_fixture == [1, 2, 3]

class TestFoo():
    @fixture
    def foo_fixture(self, foo_fixture):
        return foo_fixture + [4, 5]

    def test_foo(self, foo_fixture):
        assert foo_fixture == [1, 2, 3, 4, 5]
上の例では、TestFoo.foo_fixtureがglobal領域のfoo_fixtureを引数にとり、それを変形したものを返しています。
このように複数の変数領域に分けることで二つのfixtureの間に上位下位関係が成立して循環と重複がなくなり、
下位のfixtureから上位のfixtureを利用することが可能となります。
「別の名前のfixtureでいいじゃないか……」という意見もあるかと思いますし、役割が大きく変化してしまう場合などにはそれが正しいです。 一方、似通った名前のfixtureを量産することや、fixtureの名前が具体化するにつれて長くなってしまうのは あまり良くありません*5。
6.3 親子クラス間での同名fixtureの連鎖
では、最後にクラスを継承した場合はどうなるでしょうか。
以下の例は、ベースとなるfixtureとテストケースを用意して、 それを継承したテストを作成することで様々なパターンのテストの実装を省力化する試みです。
以下のTestInherit.test_inherit_fixtureは通るでしょうか?
class TestBase():
    EXPECTED = [1, 2]

    @fixture
    def inherit_fixture(self):
        return [1, 2]

    def test_inherit_fixture(self, inherit_fixture):
        assert inherit_fixture == self.EXPECTED


class TestInherit(TestBase):
    EXPECTED = [1, 2, 3, 4]

    @fixture
    def inherit_fixture(self, inherit_fixture):
        return inherit_fixture + [3, 4]
正解は、「通らない」です。
これはベースクラスのinherit_fixtureが上書きされるので、再帰的なfixtureとなってエラーを吐きます。
修正案としては、まずそもそもfixtureについてはベースクラスで定義しないでおいて、 ベースクラスをテスト対象から外すような修正をするのが一番だと思います。
どうしてもfixtureも使い回したい場合、 以下のようにベースのfixtureを外に出してしまうという方法があります。
@fixture
def inherit_fixture():
    return [1, 2]

class TestBase():
    EXPECTED = [1, 2]

    def test_inherit_fixture(self, inherit_fixture):
        assert inherit_fixture == self.EXPECTED

class TestInherit(TestBase):
    EXPECTED = [1, 2, 3, 4]

    @fixture
    def inherit_fixture(self, inherit_fixture):
        return inherit_fixture + [3, 4]
テストでクラスの継承を使い始めるとややこしくなるので、テストケースを継承するようなクラスはそうそう作るべきではないという意見もあります。 とはいえ、自分はこれもケースバイケースであり必要に応じて継承は使うべきだと考えているので、あえてここで紹介しました。
7.まとめ
pytestについて自分の好きな話をなんとかテーマに沿って選抜して、まとめてみました。
正直、半年前まではpytestを含めてテストを書くのは好きではなかったのですが、
pytestのテクニカルな部分に触れるうちに段々と楽しくなっていきやりすぎることも多々ありました。
また、テストを何度も書くうちにテストをしやすいようなコードを書く意識がついて、 自分の設計能力も上がったのは嬉しい誤算でした。
実務的にテストを書くという行為は、納期やリソース、チームのルールなど、非常に多くのパラメータが絡み合っており、 経験から程よいテストをいい感じに書くという、理論や知識よりも経験が求められる世界だと考えています。 なので、Pythonを書く全ての人が、まずはpytestの楽しさに気づいて、テストを書く機会を増やし、 やがてこの世界からレガシーコードが減っていけばと切に切に切に願っています。

- 作者:マイケル・C・フェザーズ
- 発売日: 2016/01/15
- メディア: Kindle版
「技術に正しく課金したいがためにアラフォーでも髪を染め続けているよ」というお話。
株式会社ホクソエム常務取締役のタカヤナギ=サンです、主に経営を担当しています。
株式会社ホクソエムの顧客、あるいは同僚から「何で君はアラフォーになっても変な髪色になっとるんじゃい?」という質問を結構いただくんで、 いい加減そのことについての私の考えをポエムにしたいなと思ってこのブログを書いています。
「いや、そんなもん会社のBLOGに書くんじゃねーよ💢」という話があるかもしれないですが、ここは私の保有する会社なので何の問題もない、don't you?
タイトルにある"技術"(テクノロジー)はより正確には”技”(テクネ、スキル)のほうが正しい気もするが、まあここでは問題としないで同義として扱っていきたく存じます。
美容室のビジネスモデル
美容室のビジネスモデルっていうのは比較的シンプルで、月当たりの売上は以下で計算できるわけです。
- 売上 = 顧客単価 x 顧客人数/月
これが一月の売上になるわけです。 利益は"売上 - 費用"で計算できますが、まあ1人でやってる小さな美容室の全部は固定費(自分の人件費と場所代)だと思えるわけです。 なので、利益を上げるためには売上を上げるしかない(固定はFixedだと思う)という構造になっています*1。
美容室の技に正しくお金を払うためには
私は今行っている美容室が好きで、適切に利益を上げ続けてビジネス的に上手く行って欲しいと思っているので、個人的にも利益に貢献していこうという気持ちがあるわけです。
で、利益に貢献しようと思うと、上のビジネスモデルの話にあるように売上に貢献しなければいけないのですが、貢献できる因子としては
- 顧客単価
- 顧客人数/月
のどちらかを上げることで貢献するしかないわけですね。
一方、メンズ(おじさん)が美容室に行く頻度なんてまあ普通月に1回くらいなもんで、その回数(顧客人数/月)を増やして大いに利益貢献するってのもありと言えばあり、もう毎週「丸坊主にしてくれ!!!」とオーダーして通いつめればいいんですが、それはちょっと技術を尊重してるとは言えないなと、なのでありよりのなしだよということになり、取れる戦略は”顧客単価の向上”一択となるわけです。
カットのみをオーダーして、高級な鮨🍣屋でやるような お心づけをお渡しする、でもまあ良いと言えばいいんですが、それは技術に課金している感じがしないなと、腕や技をリスペクトしてる感じというよりも、全体的なサービス満足度に対するチップ的な気持ちになってしまうのでなしとしています。
なので、顧客単価を上げようとすると所謂”アップセルな商品”、美容室で言うと通常のカットに加えパーマやらヘッドスパ、カラーをお願いするという選択肢がある中で、私は髪の色を変える(カラーをお願いする)ことで売上(≒利益)に貢献!という方針を取っていると、そういうことです*2。 これが私なりの”正しい技術への課金”ということです。
個人的な意見としては、”自分の見てくれ”に何の興味もない人は、髪の色ぐらいバンバンいじっちゃったらいいんじゃないかなと思っています 。 興味がない事柄だからプロにお任せして好き勝手にやってもらう、技術に課金していく、そういうことです。
まとめ
最近だと Github Sponsorsや Zennのような”すぐ投げ銭できる仕組み”が出来てきてて、 非常に良い時代になってきたんですが、まだ匠の技や技術を持つ個人商店のようなスモールビジネスに対して、どうその技術に対して課金していけばよいのかはよくわかっておらず、試行錯誤しながら応援ヤッテイキをしていこうと思います。
・・・次回も絶対見てくれよな!!!
ホクソエムのおじさんたちを勝手に踊らせた話
毎週の歯科治療が一段落し, とうとう外に出る理由が一切なくなりました。
ホクソエムサポーターのKAZYです。
6畳の部屋に籠もり続けて健康を維持できるのか不安なこの頃。 運動不足も気になります。
ホクソエムのおじさんたちもきっと同じ悩みを抱えてることでしょう。
ところで最近は静止画を簡単に踊らせてやることができるらしいです。
referenceの動画の動きに合わせて、sourceの静止画をぐりぐり動かせるAI。
— 福田敦史 / Aillis CTO (@fukumimi014) December 13, 2020
Attention機構などを使い、referenceから抽出した動きの情報をsource画像に当てはめ、Discriminatorに真偽判定させるGANを主な機構として用いているとのこと。https://t.co/YdsiRi0Enp pic.twitter.com/7xQ8oohqyo
私は閃きました。
この技術を使ってホクソエムのおじさん達をグリグリ動かす。
そうすればおじさんの運動不足は解消される。
それにより, おじさんたちは気分が良くなる。
私は感謝されご褒美をたんまりもらえる。💰💰💰💰
素晴らしいシナリオです。
天才かもしれない。
今回のアウトプット(忙しい人用)


フリー素材です。
ご自由にお持ち帰りください。
今回使う技術の流れの雰囲気なお気持ち
ホクソエムブログって実はテックブログ的なものらしい(NOT ポエム置き場)。
なので今回使う技術のお気持ち程度の解説を記しておくことにする。
この技術が発表された論文の名はLiquid Warping GAN with Attention: A Unified Framework for Human Image Synthesis。
2020年のもの。
論文に載っていたFramework OverViewに私がちょびっとコメントを追加画像がこちら。
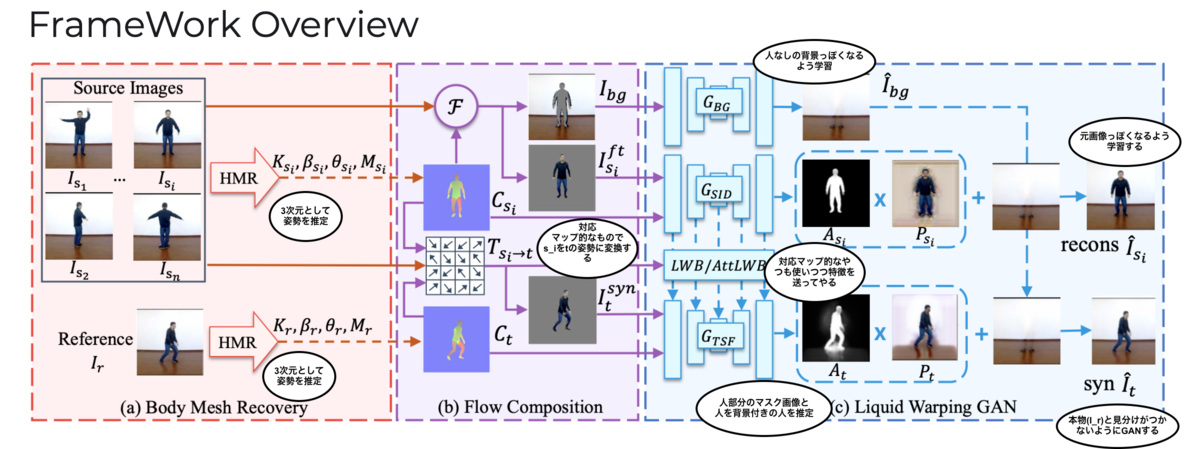
やってることはだいたいこんな感じだ。
やりたいことはSource Image をReference
のに姿勢にしたい。
なるべく自然な感じに。
それを実現するために考えられた流れは
1. 画像からHuman Mesh Recovery(HMR)というタスクを行い, 2次元画像から3次元のメッシュ情報を推定してする。
2. 3次元メッシュを考慮した画像間の人物部位の対応マップ的な をつくる (Transeformation flowと呼んでいる)。
3.を使って を
 の姿勢にした
 を生成する。
4. Convolutional Autoencoderライクな を使って の背景画像, の人部分のマスク画像と人の画像,
 の人部分のマスク画像と人の画像を作ってやる(このとき
 という機構を使って
 から
 に情報を送り込んでやっているようだ)。
5. から生成された背景画像と人の画像を合成して画像
 を作る。
6. から生成された背景画像と人の画像を合成して画像
 を作る (これがお目当てのやつやな)。
2. 3次元メッシュを考慮した画像間の人物部位の対応マップ的な
3.
4. Convolutional Autoencoderライクな
5.
6.
上の流れでいい感じの結果を得るために
- をなるだけ っぽくしたい気持ち
- を偽物,
 を本物として, それらが見分けがつかないようにした気持ち(ここがGANな要素や)
-
をあわせて学習する感じ (雑)。
あと一旦3Dメッシュにして3次元的な情報も考えているんだってところがポイントらしいです。
あとあとのところで人物を再構築するために使う特徴量を流し込んでやるところもポイントらしいです。
詳細は論文を読んでほしいです。
こちら↓のサイトに論文, コード, データセットなどなどが置いてあります。 www.impersonator.org
2021年02月現在はComing soonとなっていますが, いいのアプリケーションも開発するプロジェクトもあるようです。
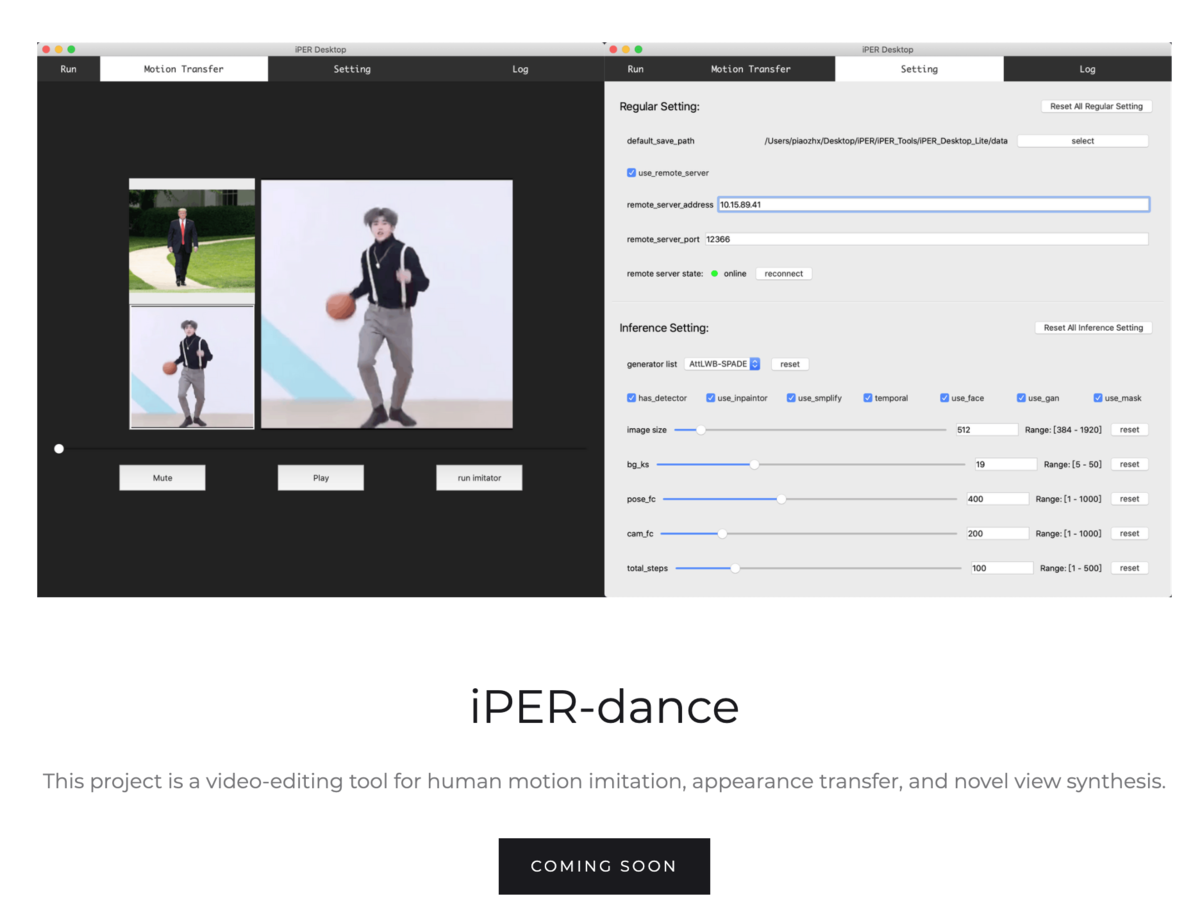
おじさんの画像を集める
本題に戻ります。
おじさんたちの画像を集めます。
画像を募ったらなおじさん3名から画像を拝借できました(たぶんフリー素材)。
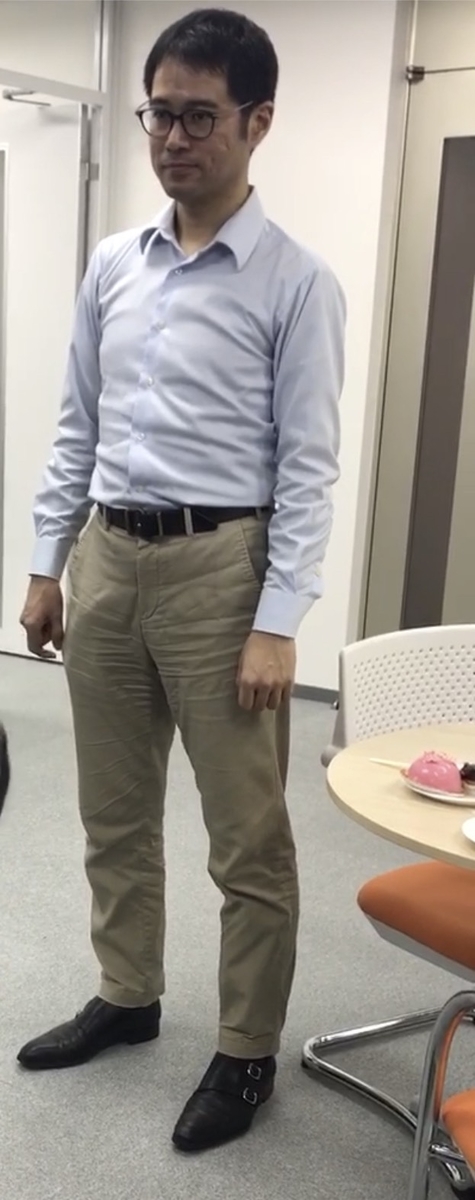
いい表情。
おじさんを動かす(その1)
この技術,嬉しいことにテストデータを動かしているノートブックが公開されているんです。
脳みそが🐵な私は画像だけ差し替えればなんか動くだろの精神でおじさん達を投入してみます。
ノートブックをしたに上から下に実行していきます。
トランプを踊らせている動画の設定のブロックにたどり着きました。
# This is a specific model name, and it will be used if you do not change it. This is the case of `trump`
model_id = "donald_trump_2"

# the source input information, here \" is escape character of double duote "
src_path = "\"path?=/content/iPERCore/assets/samples/sources/donald_trump_2/00000.PNG,name?=donald_trump_2\""


## the reference input information. There are three reference videos in this case.
# here \" is escape character of double duote "
# ref_path = "\"path?=/content/iPERCore/assets/samples/references/akun_1.mp4," \
#              "name?=akun_2," \
#              "pose_fc?=300\""

ref_path = "\"path?=/content/iPERCore/assets/samples/references/mabaoguo_short.mp4," \
             "name?=mabaoguo_short," \
             "pose_fc?=400\""

# ref_path = "\"path?=/content/iPERCore/assets/samples/references/akun_1.mp4,"  \
#              "name?=akun_2," \
#              "pose_fc?=300|" \
#              "path?=/content/iPERCore/assets/samples/references/mabaoguo_short.mp4," \
#              "name?=mabaoguo_short," \
#              "pose_fc?=400\""

print(ref_path)

!python -m iPERCore.services.run_imitator  \
  --gpu_ids     $gpu_ids       \
  --num_source  $num_source    \
  --image_size  $image_size    \
  --output_dir  $output_dir    \
  --model_id    $model_id      \
  --cfg_path    $cfg_path      \
  --src_path    $src_path      \
  --ref_path    $ref_path
あー, 完全に理解した。
ref_pathで動画, src_pathで画像を指定しているっぽいので, src_pathをおじさんに差し替えちゃえばいいんでしょう?
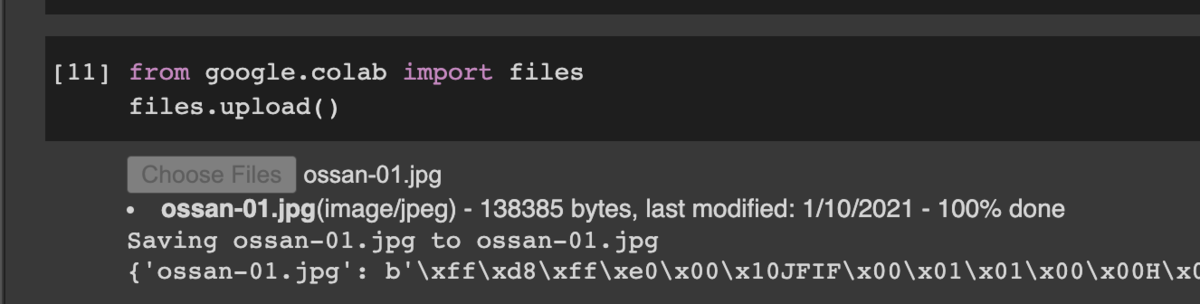
src_pathとmodel_idをおじさんに差し替えてみました。
# This is a specific model name, and it will be used if you do not change it. This is the case of `trump`
model_id = "ossan01"

# the source input information, here \" is escape character of double duote "
src_path = "\"path?=/content/iPERCore/ossan-01.jpg,name?=ossan01\""


## the reference input information. There are three reference videos in this case.
# here \" is escape character of double duote "
# ref_path = "\"path?=/content/iPERCore/assets/samples/references/akun_1.mp4," \
#              "name?=akun_2," \
#              "pose_fc?=300\""

ref_path = "\"path?=/content/iPERCore/assets/samples/references/mabaoguo_short.mp4," \
             "name?=mabaoguo_short," \
             "pose_fc?=400\""

# ref_path = "\"path?=/content/iPERCore/assets/samples/references/akun_1.mp4,"  \
#              "name?=akun_2," \
#              "pose_fc?=300|" \
#              "path?=/content/iPERCore/assets/samples/references/mabaoguo_short.mp4," \
#              "name?=mabaoguo_short," \
#              "pose_fc?=400\""

print(ref_path)

!python -m iPERCore.services.run_imitator  \
  --gpu_ids     $gpu_ids       \
  --num_source  $num_source    \
  --image_size  $image_size    \
  --output_dir  $output_dir    \
  --model_id    $model_id      \
  --cfg_path    $cfg_path      \
  --src_path    $src_path      \
  --ref_path    $ref_path
あと, 一つ前のセルでnum_source = 2となっていますが, 今回はおじさん画像は1枚なのでnum_source = 1に修正しました。
そしてRun the trump caseのブロックを実行してみます。
待つこと数分。。。
----------------------MetaOutput----------------------
ossan01 imitates mabaoguo_short in ./results/primitives/ossan01/synthesis/imitations/ossan01-mabaoguo_short.mp4
------------------------------------------------------
Step 3: running imitator done.
という表示がでました。 どうやら終わったようです。
おおおおおおおお!!!!! 動いたーーー!
おじさんがおじさんの動画と同じ動きをしております。
なにかの武術を完全にマスターしていますね。
素晴らしい。 強そう。
おじさんを運動せてみる(その2)
今度は別のおじさんを動かしてみましょう。
こちらのおじさん(多分ホクソエムの社長さん)。
先程はサンプルー動画でしたが動画もこちらが指定したものに差し替えてみましょう。
ref_pathを適当に拾ってきた動画に変更します。
あとおじさんも別のおじさんに変えてみます。
社長さんに変な動きをさせている背徳感が堪らない。。。
あと単純に普段していないであろう動きをしているおじさんが面白い。
おじさんを運動せてみる(その3)
調子に乗って最後は激しいダンスとかおじさんにさせてみようと思います。
踊るおじさんがよりリアルになってほしいので今回は正面と背面と2枚の画像を入力してみます。
GO!!!
いやぁ...お腹が痛い。。。
キレッキレじゃないですか。
たまにありえない動きしちゃうあたりが, 手法的にはマイナスなんでしょうがお笑い的には◎。
いやぁ 笑った笑った。
最後に
今回はLiquid Warping GAN with Attention: A Unified Framework for Human Image Synthesisという論文の手法を用いてホクソエムのおじさんの画像を動画と混ぜ合わせて動かしました。
実装がColaboratoryにアップロードされておりとても簡単に動かすことができました。
アウトプットを見るのがとにかく面白かったので, 皆様も身近な人で試してみてはいかがでしょうか。
おじさん達の運動不足を解消したので私はホクソエムからボーナス間違いなしですね 。💴💴💴💴💴
